Der Mythos von der neutralen Maschine
Eine Computer-Ausgabe kann dazu verleiten, ihr besonders zu vertrauen. Wenn der Rechner sagt: „Kredit abgelehnt“ oder „Bewerber nicht geeignet“, wirkt das schnell wie ein nüchternes mathematisches Faktum. Ein Computer hat schließlich keine schlechte Laune und mag niemanden lieber als andere, oder?
Doch. KI hat zwar keine Gefühle, aber sie hat „Lehrmeister“ – und das sind wir. Wie wir im Kapitel über Training gelernt haben, lernen Modelle anhand von Beispielen. Diese können Ausschnitte unserer echten, unperfekten Welt abbilden.
Wie Vorurteile in die Maschine kommen (Bias)
Diesen Effekt nennt man „Bias“ (engl. für Verzerrung oder Voreingenommenheit). Er kann unabsichtlich entstehen, etwa durch die Auswahl der Trainingsdaten. Auch ungeeignete Lernziele und Entscheidungen bei Entwicklung und Einsatz spielen eine Rolle.
Stell dir vor, eine KI soll lernen, gute Führungskräfte zu erkennen. Man füttert sie mit den Lebensläufen erfolgreicher Manager der letzten 30 Jahre.
Das Problem: Nehmen wir für dieses Beispiel an: 90% der ausgewählten Lebensläufe aus den letzten 30 Jahren stammen von Männern.
Die KI könnte daraus lernen: „Mann sein“ ist ein statistisches Merkmal für Erfolg.
Wenn nun die Bewerbung einer Frau kommt, könnte die KI sie deshalb schlechter bewerten oder aussortieren. Nicht aus Bosheit, sondern wegen ihres gelernten Musters. So kann sie die Vergangenheit wiederholen, statt die Zukunft zu gestalten.
Garbage In, Garbage Out (Müll rein, Müll raus)
In der Informatik gibt es einen alten Merksatz: „Garbage In, Garbage Out“. Die Qualität der Eingaben beeinflusst die Antwort wesentlich. Sie ist aber nicht der einzige Faktor: Auch Modell, Lernziel und Einsatzbedingungen zählen.
Das betrifft nicht nur Geschlechterfragen, sondern ganz praktische Dinge im Alltag:
- Gesichtserkennung: Eine NIST-Untersuchung von 2019 fand bei vielen Gesichtserkennungsalgorithmen unterschiedliche Fehlerraten zwischen Bevölkerungsgruppen, unter anderem höhere Verwechslungsraten bei Schwarzen Frauen. Das hing vom Algorithmus und der Aufgabe ab. Die Studie belegte nicht, dass die Trainingsdaten allein die Ursache waren.
- Medizin: Eine Studie von 2022 zeigte bei den untersuchten Modellen zur Erkennung von Hauterkrankungen eine geringere Treffsicherheit auf Bildern dunkler Haut. Zusätzliches Training mit vielfältigeren Bildern konnte diese Lücke im Test verringern. Das Ergebnis gilt für die untersuchten Modelle und ist keine Aussage über jede heutige Hautkrebs-KI.
- Spracherkennung: Dialekte können Spracherkennung erschweren. Eine Untersuchung von 2025 fand bei den getesteten Modellen mehr Fehler für süddeutsche Dialekte als für Standarddeutsch. Wie gut Siri & Co. heute etwa „Bayrisch“ oder „Sächsisch“ verstehen, lässt sich daraus nicht pauschal ableiten; Modell und Trainingsmaterial spielen eine Rolle.
Warum „Datenbereinigung“ so schwer ist
Man könnte nun sagen: „Dann löscht doch einfach das Geschlecht aus den Daten!“ Doch so einfach ist es nicht. KI kann Korrelationen (Zusammenhänge) nutzen, die uns nicht sofort auffallen.
Eine 2019 veröffentlichte US-Studie untersuchte einen Algorithmus, der Patienten mit hohem Versorgungsbedarf finden sollte. Die Zugehörigkeit zu einer ethnischen Gruppe ging nicht direkt als Merkmal ein.
Trotzdem wurde der Bedarf Schwarzer Patienten unterschätzt.
Warum? Der Algorithmus sagte Gesundheitskosten voraus, nicht den tatsächlichen Behandlungsbedarf. Für Schwarze Patienten wurde bei vergleichbarem Bedarf weniger Geld ausgegeben. Kosten waren deshalb eine verzerrte Ersatzgröße: Eine niedrigere Kostenvorhersage bedeutete nicht, dass jemand weniger Hilfe brauchte.
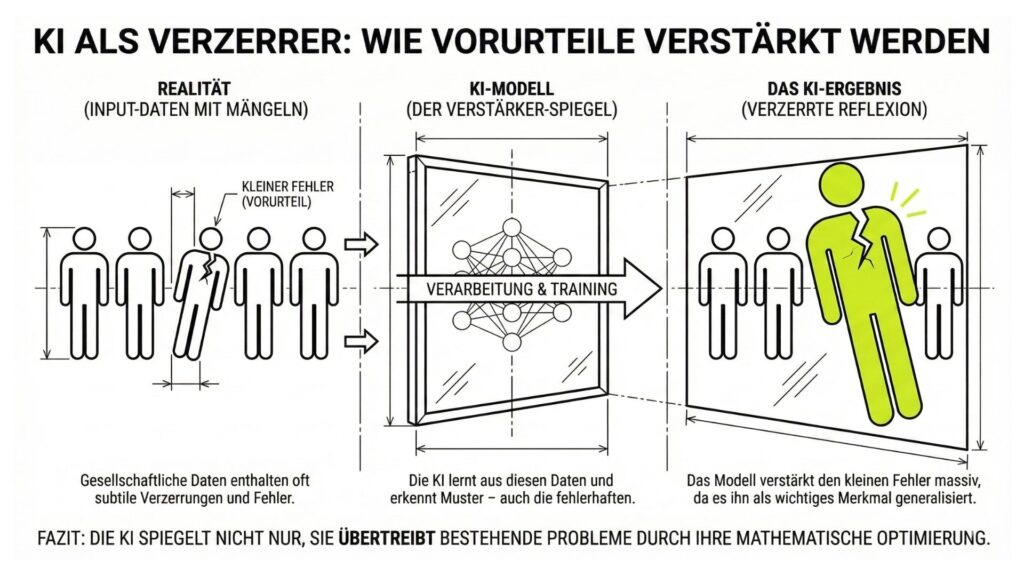
Die Grafik zeigt, wie KI vorhandene Verzerrungen verstärken kann. Das geschieht nicht zwangsläufig bei jedem Modell. Auch Lernziele, Entwicklung und Einsatz können zu unfairen Ergebnissen beitragen.
Fazit: Vertrauen ist gut, Kontrolle ist besser
Was bedeutet das für dich? Wenn du hörst „Eine KI hat das berechnet“, sei skeptisch. Frage dich:
KI ist ein Spiegel unserer Gesellschaft. Wenn wir hineinschauen und uns Fratzen sehen, kann das an dem liegen, was davor steht – aber auch daran, wie der Spiegel gebaut und benutzt wird.
Glossar: Fachbegriffe zu Daten & Ethik
| Begriff | Erklärung |
|---|---|
| Bias (sprich: „Bai-es“) | Eine systematische Verzerrung, die zu unfairen Ergebnissen führen kann (z.B. zur Benachteiligung bestimmter Gruppen). |
| Trainingsdaten | Das „Futter“ für die KI. Sind sie einseitig, kann auch die KI einseitige Ergebnisse liefern. |
| Diskriminierung durch Algorithmen | Wenn der Einsatz von Algorithmen bestimmte Menschengruppen benachteiligt. Ursachen können in Daten, Lernzielen oder der Gestaltung und Nutzung des Systems liegen; eine böse Absicht ist dafür nicht nötig. |
| Korrelation | Ein statistischer Zusammenhang, etwa zwischen Regen und nassem Rasen. Der Zusammenhang allein beweist noch nicht die Ursache. Viele Lernverfahren nutzen solche Muster, ohne damit die Ursache nachzuweisen. |
Kommentar