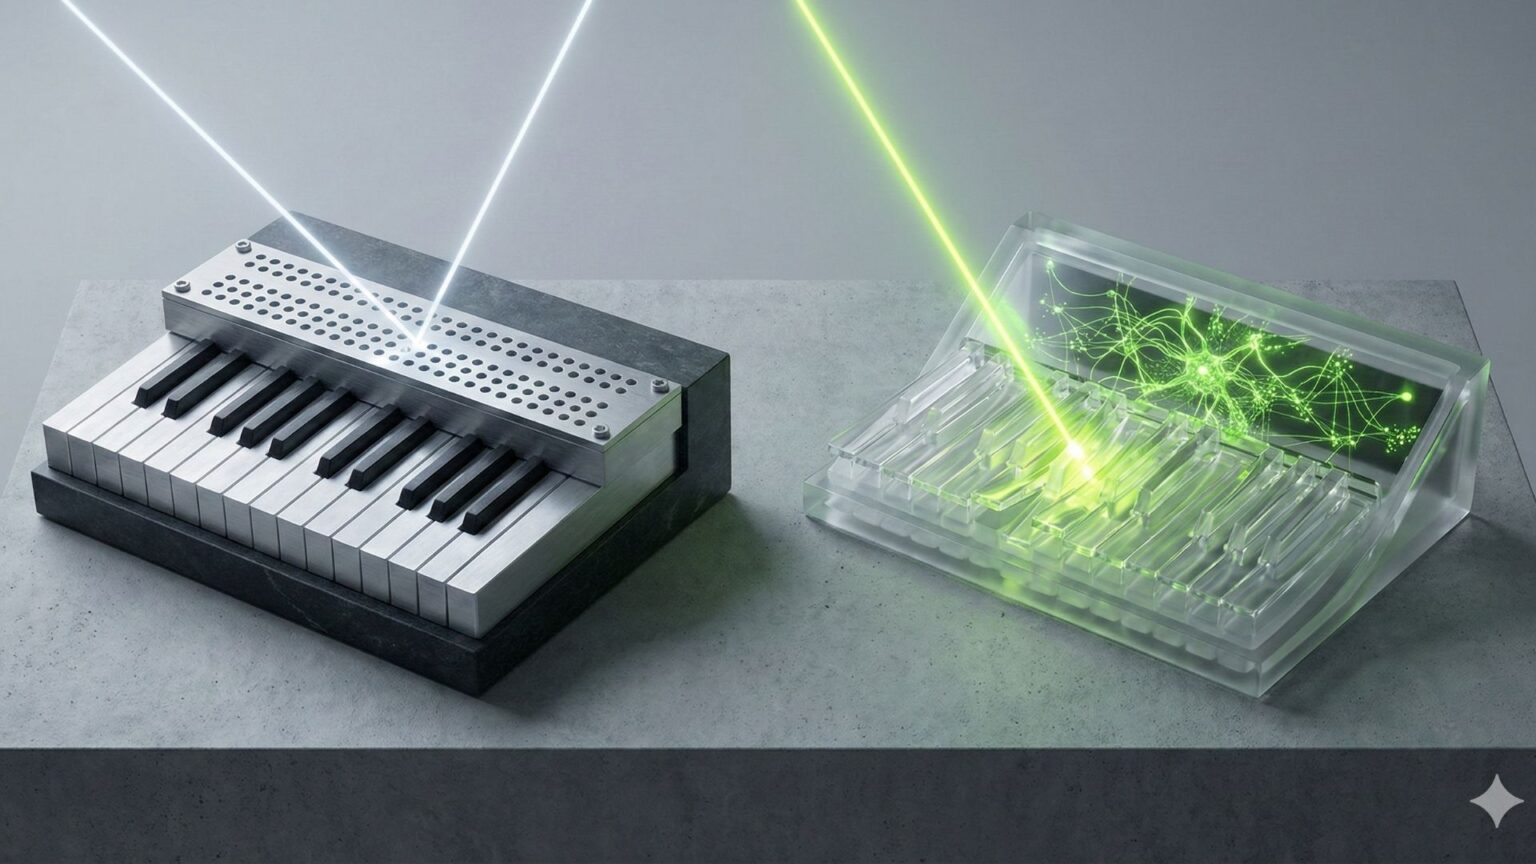
Früher vs. Heute: Der Klavier-Vergleich
Um den gewaltigen Unterschied zwischen fest vorgegebenen Rechenregeln (wie einer Excel-Formel) und maschinellem Lernen zu verstehen, stellen wir uns vor, wir wollten einem Computer das Klavierspielen beibringen.
Die alte Methode (Klassische Programmierung): Ein Programmierer schreibt jede einzelne Note auf. Er definiert exakt: „Drücke Taste C für 0,5 Sekunden, dann Taste E für 0,2 Sekunden.“ Das Programm spielt die vorgegebene Tastenfolge ab. Ist das Klavier verstimmt, klingt sie anders; ein heruntergefallenes Notenblatt verändert die gespeicherten Befehle nicht. Auf Neues reagiert dieses einfache Programm nur, wenn dafür Regeln vorgesehen sind.
Die neue Methode (Maschinelles Lernen): Auch hier werden Verfahren und Ziel vorgegeben. Eine mögliche Form des Lernens durch Rückmeldung kannst du dir so vorstellen: Man setzt die KI ans Klavier und sagt: „Spiel mir Mozart!“ Die KI drückt zufällige Tasten. Es klingt schrecklich (Krach). Das System bekommt sofort Feedback: „Falsch! Das war kein Mozart.“ Die KI versucht es erneut und verändert die Tastenabfolge. Vielleicht lautet die Rückmeldung nun: „Falsch, aber etwas besser.“
Diesen Prozess kann sie sehr oft wiederholen. Mit einer passenden Bewertung kann sie durch Ausprobieren und Rückmeldung Tastenfolgen finden, die wie Mozart klingen. Das beweist noch kein Verständnis von Mozart. Auch das bloße Auswendiglernen von Beispielen ist beim Training möglich und kann später zu Fehlern führen.
Wie das „Üben“ in der Praxis funktioniert
Der Klavier-Vergleich ist ein vereinfachtes Bild für Lernen durch Rückmeldung. Andere Verfahren arbeiten anders, etwa mit Bildern und den dazugehörigen richtigen Antworten.
Beispiel: Hund oder Katze?
Stell dir vor, du willst einem Computer beibringen, Hunde von Katzen zu unterscheiden. Ohne KI müsstest du Regeln schreiben: „Wenn spitze Ohren, dann Katze.“ (Problem: Schäferhunde haben auch spitze Ohren. Das Programm scheitert.) Mit KI (Training): Du zeigst der KI zum Beispiel 10.000 als Katze und 10.000 als Hund beschriftete Bilder. Ein noch untrainiertes Modell liegt am Anfang häufig daneben. Beim Training werden die einstellbaren Zahlen im Modell („Gewichtungen“) anhand der Abweichung von den richtigen Antworten angepasst. Dabei kann es statistische Muster lernen, etwa Zusammenhänge von Formen und Abständen im Gesicht. Ob die 20.000 Bilder reichen und welche Merkmale das Modell tatsächlich nutzt, muss man prüfen – auch an neuen Bildern.
Warum KI trotzdem nicht „denkt“
Es ist verlockend, diesem Prozess menschliche Eigenschaften zuzuschreiben („Die KI übt fleißig“). Aber Vorsicht: Es ist reine Mathematik.
Ein Kind kann die Traurigkeit oder Fröhlichkeit der Musik erleben. Ein KI-Modell wird dagegen nach einem rechnerischen Ziel trainiert, etwa auf möglichst geringe Abweichungen oder möglichst gute Bewertungen. Dass es passende Tastenfolgen erzeugt, belegt kein menschliches Erleben der Musik.
Experten sprechen durchaus von „Maschinellem Lernen“. „Training“ bezeichnet dabei das Anpassen eines Modells; „Mustererkennung“ ist eine mögliche Aufgabe. Eine überzeugende Ausgabe belegt noch kein menschliches Verständnis und kann trotzdem falsch sein.
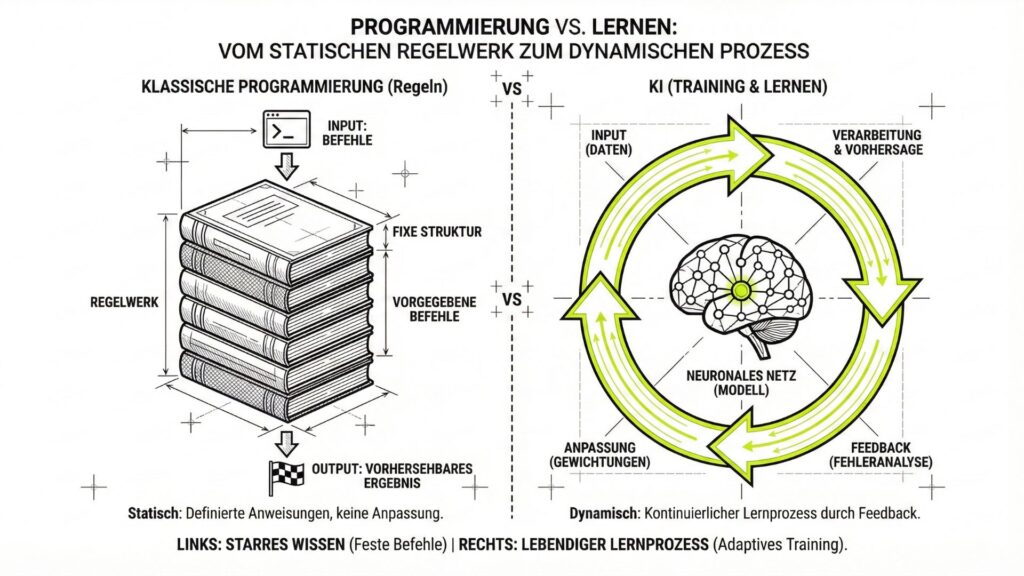
Die Grafik stellt zwei Vorgehensweisen vereinfacht gegenüber. Auch Lernverfahren werden programmiert. Die Rückkopplung rechts zeigt die Trainingsphase; ein eingesetztes Modell lernt nicht automatisch fortlaufend weiter.
Warum Training so viele Daten braucht
Menschen und KI lernen auf unterschiedliche Weise; eine feste Zahl wie „drei Katzen“ beschreibt das nicht zuverlässig. Gerade große Bildmodelle werden oft mit sehr vielen Beispielen vortrainiert. Für eine neue Aufgabe können sie anschließend mit deutlich weniger zusätzlichen Daten auskommen.
Warum braucht das Training oft viele Daten? Ein Bildmodell verarbeitet Zahlenwerte der Pixel und muss daraus brauchbare Muster gewinnen. Vorwissen kann bereits im trainierten Modell stecken. Wie viel Übungsmaterial nötig ist, hängt unter anderem von der Aufgabe, dem Modell und der Vielfalt der Bilder ab.
Fazit: Fehler sind Teil des Systems
Bei klassischer Software (z.B. einem Taschenrechner) ist 2+2 immer 4. Wenn nicht, liegt ein Fehler vor – etwa bei der Eingabe, im Programm oder am Gerät. Bei KI ist das anders. Ein Modell kann sich bei seiner Zuordnung irren, auch wenn es etwa „Zu 99% ist das eine Katze“ ausgibt. Diese Zahl ist eine Modellschätzung und keine Richtigkeitsgarantie. Wie ein Klavierschüler, der sich verspielt, kann auch eine gut trainierte KI Fehler machen.
Das zu wissen ist wichtig: Eine KI-Ausgabe ist keine Garantie für die Wahrheit; wie gut sie ist, hängt vom Modell und von der Aufgabe ab.
Glossar: Die Sprache des Trainings
| Begriff | Erklärung |
|---|---|
| Maschinelles Lernen (ML) | Verfahren, bei denen ein programmiertes Lernverfahren ein Modell anhand von Daten anpasst, statt jede Lösung einzeln vorzugeben. |
| Trainingsdaten | Das Material (Bilder, Texte, Töne), mit dem die KI übt. Ohne gute Daten kein gutes Lernen. |
| Modell | Das „fertige“ Ergebnis nach dem Training. So wie der Schüler nach dem Üben das Lied „kann“, soll das Modell die Aufgabe lösen können; ob das auch mit neuen Eingaben gelingt, muss geprüft werden. |
| Feedback-Schleife | Ein Mechanismus, der Ergebnisse bewertet und diese Rückmeldung zur Anpassung nutzt. Die Rückmeldung kann abgestuft sein; nicht jedes Lernverfahren braucht ausdrücklich „richtig“ oder „falsch“. |
Kommentar